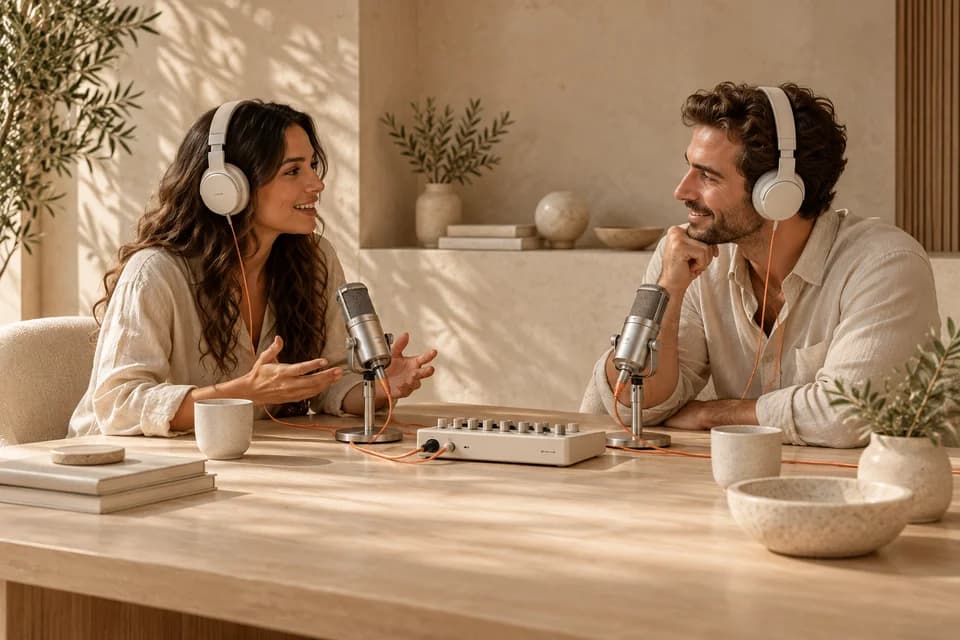
To perspektiver i podkasten
En produsent skriver en samtale mellom programleder og gjest. To stemmer skiller spørsmål fra svar. Replikkene blir til én lydfil der lytterne kan følge begge perspektivene i det planlagte innslaget.
Gi manuset opptil fire stemmer, og lag samtaler til podkaster, fortellinger og undervisning.
De genererte dialogene dine vises her.
I podkaster, historier og øvelser er det viktig hvem som sier hva. Ulike stemmer gjør spørsmål, svar og reaksjoner gjenkjennelige gjennom hele samtalen.
En produsent skriver en samtale mellom programleder og gjest. To stemmer skiller spørsmål fra svar. Replikkene blir til én lydfil der lytterne kan følge begge perspektivene i det planlagte innslaget.
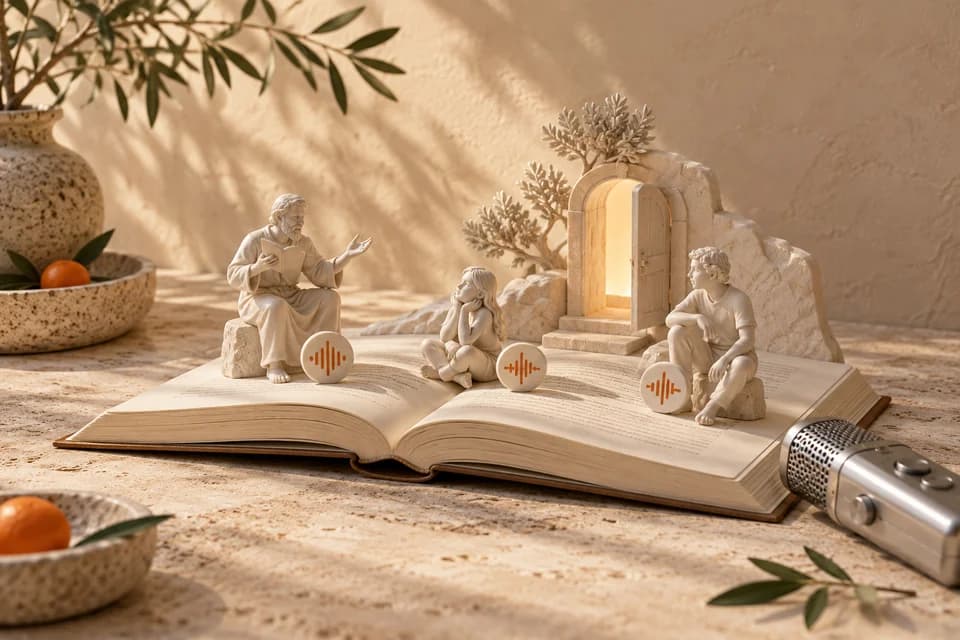
En scene veksler mellom en forteller og to figurer. Fortelleren beskriver omgivelsene, mens figurene driver handlingen med egne stemmer. Rekkefølgen gjør både hendelser og bytter av taler tydelige.
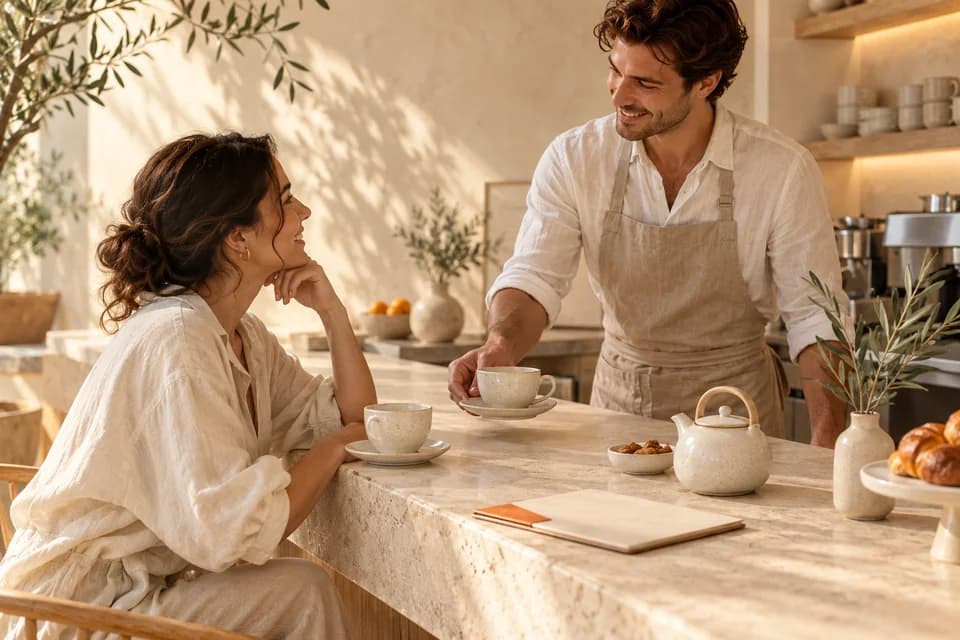
En språklærer bruker en kafébestilling som lytteøvelse. Kunde og servitør får ulike stemmer. Samtalen kan følge et oppgaveark og vise hvordan enkeltuttrykk henger sammen i en hverdagssituasjon.
En instruktør demonstrerer en samtale mellom kunde og support. En stemme per rolle skiller henvendelsen fra svaret. Lyden kan ledsage lysbilder eller spørsmål om hvordan teamet håndterer den konkrete situasjonen.
Åpne voicv.com, logg inn og velg Tekst til tale med flere stemmer. Legg til én til fire personer, gi dem navn og velg lagrede stemmer som er kompatible med modellen.
Skriv replikker eller importer tekst. Del den etter avsnitt eller et eget skilletegn, og velg personene i forhåndsvisningen. Hver person må ha en stemme og minst én utfylt replikk.
Velg V3, V4 eller V5, hastighet, volum og format. Kontroller antall kreditter før du genererer. Lytt til resultatet og last det ned, eller rediger manuset og generer på nytt.
Tildel lagrede, kompatible stemmer til opptil fire roller. Hver replikk har en navngitt taler, slik at fortellere, programledere og figurer forblir tydelige når du bygger opp samtalen.
Skriv eller importer replikker, bytt talere og flytt replikkene i ønsket rekkefølge. Still inn hastighet, volum og støttede uttrykkstagger for å forme både innholdet og måten det sies på.
Replikkene genereres i manusrekkefølge som én MP3-, WAV- eller Opus-fil. Spill av og last ned samtalen til programmer, kurs eller videre redigering, og finn tidligere resultater i dialoghistorikken.
Én til fire. Hver person trenger navn, en gyldig lagret stemme og minst én replikk med tekst. Fjern personer uten replikker før du genererer.
Ja. Lim inn teksten, del den etter avsnitt eller skilletegn og fordel rollene i forhåndsvisningen. Importen organiserer teksten; den skriver ikke manuset og identifiserer ikke personene automatisk.
MP3, WAV eller Opus, valgt før generering. Hele dialogen kommer i én fil. Det følger ikke med separate stemmespor; videre redigering kan gjøres i programmet du foretrekker.
V3 og V4 bruker 1,5 kreditter per UTF-8-byte, mens V5 bruker 5. Person-taggene teller med, og summen rundes opp til hele kreditter. Se prisanslaget i verktøyet: byte er ikke det samme som tegn.
Gratis kontoer tillater opptil 15 000 UTF-8-byte per dialog, betalte abonnementer opptil 30 000, inkludert person-tagger. Tegn bruker ulikt antall byte. Følg telleren i redigeringsverktøyet.
Ja, når du er logget inn. Stemmen må være kompatibel med valgt modell, V3, V4 eller V5. Opprett eller klon stemmen på forhånd i den aktuelle funksjonen.
Utkastet for den innloggede kontoen lagres lokalt i denne nettleseren. Genereringene vises i dialoghistorikken. Dette er ikke synkronisering mellom enheter; ta en egen kopi av viktige manus.
Du kan se verktøyet og eksemplene uten å logge inn. Personlige stemmer og generering krever innlogging. Logg inn før du skriver et langt manus, siden tekst fra før innlogging ikke garantert blir beholdt.
Velg personene, skriv den første utvekslingen og lytt til flyten. Din neste podkast, fortelling eller lytteøvelse begynner med manuset.