Dwa spojrzenia w podcaście
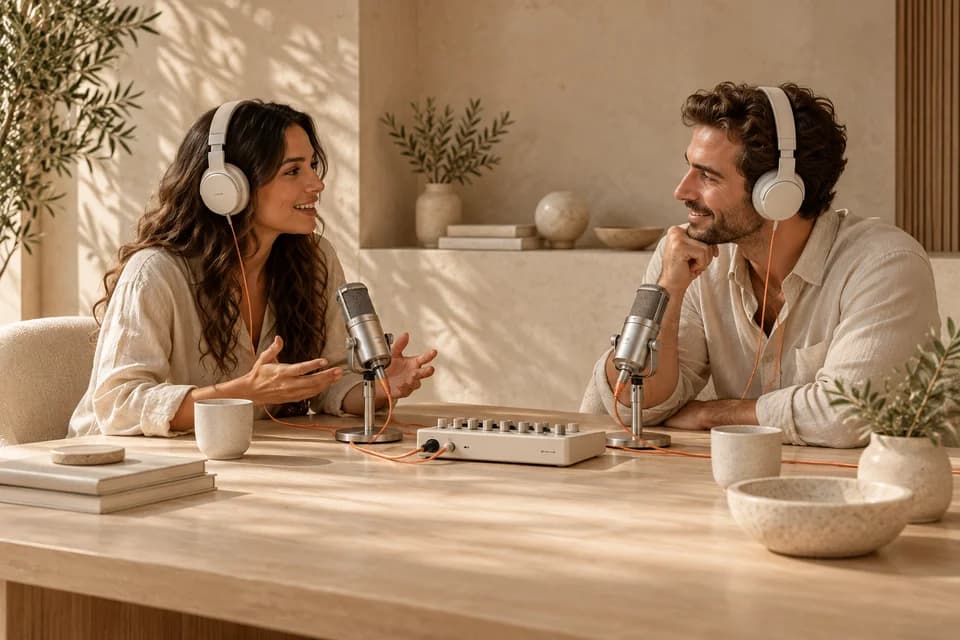
Producent przygotowuje rozmowę prowadzącego z gościem na podstawie scenariusza. Dwa głosy odróżniają pytania od odpowiedzi. Uporządkowane kwestie tworzą jeden plik audio, w którym słuchacz może śledzić oba punkty widzenia.
Nadaj postaciom maksymalnie cztery głosy i twórz dialogi do podcastów, opowieści oraz lekcji.
Wygenerowane dialogi pojawią się tutaj.
W podcastach, opowiadaniach i ćwiczeniach liczy się to, kto mówi. Różne głosy pozwalają śledzić pytania, odpowiedzi i reakcje w całej rozmowie.
Producent przygotowuje rozmowę prowadzącego z gościem na podstawie scenariusza. Dwa głosy odróżniają pytania od odpowiedzi. Uporządkowane kwestie tworzą jeden plik audio, w którym słuchacz może śledzić oba punkty widzenia.
Scena przechodzi między narratorem i dwiema postaciami. Narrator opisuje miejsce, a bohaterowie rozwijają akcję własnymi głosami. Kolejność wypowiedzi pozwala rozpoznać zarówno wydarzenia, jak i zmianę rozmówcy.
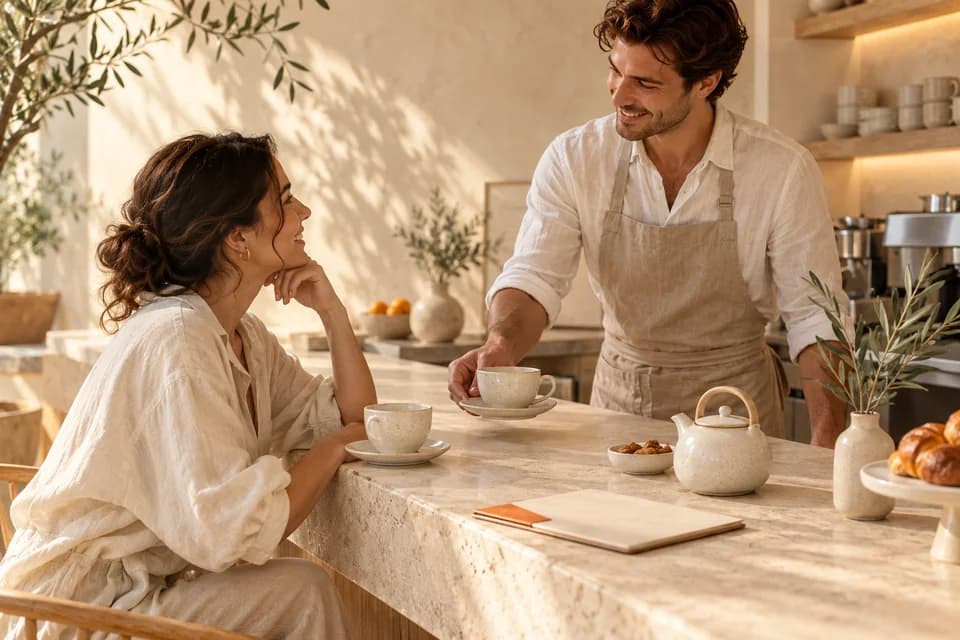
Nauczycielka przygotowuje zamówienie w kawiarni jako ćwiczenie słuchowe. Klient i obsługa otrzymują różne głosy. Cała rozmowa uzupełnia kartę pracy i pokazuje, jak pojedyncze wyrażenia łączą się w codziennej sytuacji.
Trener przedstawia rozmowę klienta z pracownikiem wsparcia. Osobny głos dla każdej roli odróżnia prośbę od odpowiedzi. Nagranie uzupełnia slajdy lub pytania do przećwiczenia konkretnej sytuacji w zespole.
Otwórz voicv.com, zaloguj się i wybierz Tekst na mowę z wieloma głosami. Dodaj od jednej do czterech postaci, nadaj im imiona i wybierz zapisane głosy zgodne z modelem.
Wpisz kwestie lub zaimportuj tekst. Podziel go według akapitów albo własnego separatora i przypisz role w podglądzie. Każda postać potrzebuje głosu i przynajmniej jednej niepustej kwestii.
Wybierz V3, V4 lub V5, szybkość, głośność i format. Sprawdź wyświetloną liczbę kredytów przed generowaniem. Odsłuchaj i pobierz wynik albo popraw scenariusz i wygeneruj go ponownie.
Nadaj zapisane, zgodne głosy maksymalnie czterem rolom. Każda kwestia ma nazwanego mówcę, więc narratorzy, prowadzący i postacie pozostają rozpoznawalni podczas układania rozmowy.
Pisz lub importuj kwestie, zmieniaj mówców i kolejność wypowiedzi. Ustaw prędkość, głośność i obsługiwane przez model znaczniki ekspresji, aby kształtować treść oraz jej interpretację.
Kwestie są generowane w kolejności scenariusza jako jeden plik MP3, WAV lub Opus. Odsłuchaj i pobierz rozmowę do programu, lekcji lub montażu; wcześniejsze wyniki znajdziesz w historii dialogów.
Od jednej do czterech. Każda musi mieć imię, prawidłowy zapisany głos i co najmniej jedną niepustą kwestię. Przed generowaniem usuń postacie bez wypowiedzi.
Tak. Wklej tekst, podziel go według akapitów lub separatora i przypisz role w podglądzie. Import porządkuje tekst, ale nie pisze scenariusza ani nie identyfikuje automatycznie postaci.
MP3, WAV i Opus, wybierane przed generowaniem. Cała rozmowa trafia do jednego pliku, bez osobnych ścieżek głosowych. Dalszy montaż możesz wykonać w swoim edytorze.
V3 i V4 zużywają 1,5 kredytu za bajt UTF-8, a V5 — 5. Znaczniki postaci też są wliczane; suma jest zaokrąglana w górę do pełnego kredytu. Sprawdź wycenę w edytorze: bajty nie są znakami.
Darmowe konto pozwala na 15 000 bajtów UTF-8 na dialog, a płatny plan na 30 000, wraz ze znacznikami postaci. Znaki zajmują różną liczbę bajtów, dlatego kieruj się licznikiem w edytorze.
Tak, po zalogowaniu. Głos musi być zgodny z wybranym modelem V3, V4 lub V5. Utwórz go lub sklonuj wcześniej za pomocą odpowiedniej funkcji.
Szkic zalogowanego konta jest zapisywany lokalnie w tej przeglądarce. Wygenerowane zadania są w historii dialogów. To nie jest synchronizacja między urządzeniami; ważne scenariusze zapisuj także osobno.
Edytor i przykłady można oglądać bez logowania. Własne głosy i generowanie wymagają zalogowania. Zrób to przed pisaniem długiego tekstu, bo zachowanie treści wpisanej przed logowaniem nie jest gwarantowane.
Wybierz postacie, napisz pierwszą wymianę zdań i posłuchaj jej rytmu. Tak zaczyna się kolejny podcast, opowieść lub ćwiczenie ze słuchu.